1.golang的协程控制有几种?
| 控制方式 | 核心用途 | 关键实现/包 | 典型场景 |
|---|---|---|---|
| WaitGroup | 等待多个goroutine完成 | sync.WaitGroup |
批量任务汇总(如并行下载多个文件) |
| Channel | 数据传递与同步 | chan类型 |
生产者-消费者模型、并发限流 |
| Context | 协程生命周期管理 | context.Context |
请求超时控制、批量取消操作 |
| Mutex | 共享资源互斥访问 | sync.Mutex/sync.RWMutex |
保护全局变量、防止并发写冲突 |
| Semaphore | 限制并发数量 | 带缓冲的Channel | 连接池、资源池(如限制最多10个并发请求) |
| Once | 确保函数只执行一次 | sync.Once |
单例模式初始化、配置加载 |
| Select | 多路channel复用 | select语句 |
超时处理、任务优先级调度 |
| Pool | 对象复用与内存优化 | sync.Pool |
减少GC压力(如HTTP请求对象复用) |
2.channel
2.1 channel的底层原理?
底层是一个叫做hchan的结构体,通过hchan结构体的buf,并使用copy内存的方式进行通信,最后达到了共享内存的目的。结构如下:
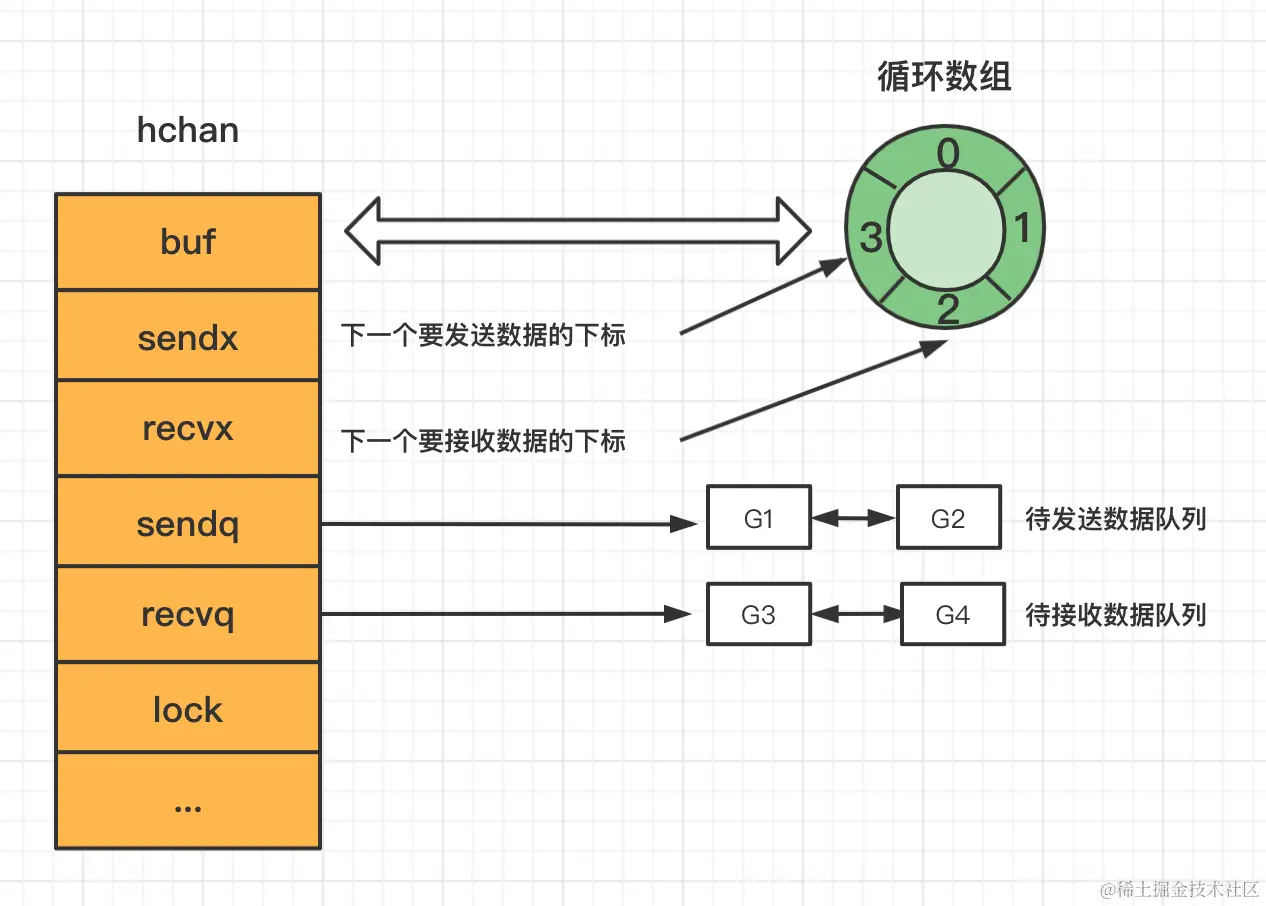
总结hchan结构体的主要组成部分有四个:
用来保存goroutine之间传递数据的循环链表 =====> buf。
用来记录此循环链表当前发送或接收数据的下标值 =====> sendx和recvx。
用于保存向该chan发送和从改chan接收数据的goroutine的队列 =====> sendq 和 recvq。
保证channel写入和读取数据时线程安全的锁 =====> lock。
相关链接:hchan结构体
2.2 channel是什么,有哪些用途,如何处理阻塞?
(1) Channel(通道)是用于在goroutines之间进行通信的一种机制。通道提供了一种并发安全的方式来进行goroutines之间的通信。
(2) 用途:
- 数据传递: 主要⽤于在goroutines之间传递数据,确保数据的安全传递和同步。
- 同步执⾏: 通过Channel可以实现在不同goroutines之间的同步执⾏,确保某个goroutine在另⼀个goroutine完成某个操作之前等待。
- 消息传递: 适⽤于实现发布-订阅模型或通过消息进⾏事件通知的场景。
- 多路复⽤: 使⽤ select 语句,可以在多个Channel操作中选择⼀个⾮阻塞的执⾏,实现多路复⽤。
(3) 如何处理阻塞:
- 缓冲通道,在创建通道时指定缓冲区⼤⼩,即创建⼀个缓冲通道。当缓冲区未满时,发送数据不会阻塞。当缓冲区未空时,接收数据不会阻塞。
select语句⽤于处理多个通道操作,可以⽤于避免阻塞。- 使⽤
time.After创建⼀个定时器,可以在超时后执⾏特定的操作,避免永久阻塞。select语句中使⽤default分⽀,可以在所有通道都阻塞的情况下执⾏⾮阻塞的操作。
3.字符串拼接的几种方式,哪种效率最好,底层实现什么样子的?
在Go语言中,字符串拼接有以下几种方式:
- 使用
+操作符:可以直接使用+将多个字符串连接起来。例如:str := "hello" + " world"。 - 使用
fmt.Sprintf函数:通过格式化字符串的方式进行拼接。例如:str := fmt.Sprintf("%s %s", "hello", "world")。 -
使用
strings.Builder结构体:先创建一个strings.Builder,然后使用WriteString方法将字符串写入,最后通过String方法获取拼接后的字符串。示例如下:1 2 3 4
var builder strings.Builder builder.WriteString("hello") builder.WriteString(" world") str := builder.String()
-
使用
bytes.Buffer结构体:与strings.Builder类似,不过bytes.Buffer是针对字节切片的操作,最后可以通过string函数将其转换为字符串。示例代码如下:1 2 3 4
var buffer bytes.Buffer buffer.WriteString("hello") buffer.WriteString(" world") str := string(buffer.Bytes())
- 一般来说,
strings.Builder的效率是比较高的。其底层实现是基于切片,在拼接过程中会根据需要自动扩容,避免了频繁的内存分配和复制,从而提高了效率。bytes.Buffer的底层实现原理与strings.Builder类似,不过它是操作字节切片,在转换为字符串时可能会有一些额外的开销。- 使用
+操作符进行字符串拼接时,每次拼接都会创建一个新的字符串,并将原来的字符串内容复制到新的字符串中,随着拼接次数的增加,效率会逐渐降低。fmt.Sprintf函数在格式化字符串时会进行一些额外的处理,效率也相对较低。
4.go的性能分析和go的内存管理
4.1 性能分析工具
1.pprof
- 简介:Go内置性能分析工具,通过采样捕获CPU、内存、阻塞等信息
- 用途:定位热点函数、内存泄漏、锁竞争等问题
-
命令示例:
1
2
   go tool pprof http://localhost:6060/debug/pprof/profile  # CPU分析
   go tool pprof http://localhost:6060/debug/pprof/heap     # 内存分析
2.trace可视化
- 简介:基于时间轴展示goroutine调度、系统调用、GC周期等细节
- 用途:分析并发瓶颈、可视化程序执行流程
-
使用流程:
1
2
3
   f, _ := os.Create("trace.out")
   trace.Start(f)
   defer trace.Stop()
1
   go tool trace trace.out  # 打开可视化界面
4.2 内存管理机制
1.分配策略
- 三级缓存架构:
- mcache(线程本地缓存):快速分配微/小对象(无需加锁)
- mcentral(中心缓存):跨P的对象分配池
- mheap(堆内存):大对象直接分配,负责内存与OS交互
-
分配流程:
   小对象(<32KB) → mcache(快速分配) → mcentral(缓存不足时)
   大对象(≥32KB) → 直接从mheap分配
2.垃圾回收(GC)
-
核心算法:三色标记清除 + 并发标记
黑色:表示有用的对象,并且已经分析扫描完 灰色:有用,但是未分析扫描完 白色:暂时无用
- 四阶段流程:
1.STW初始化(短暂暂停):标记根对象
2.并发标记:与用户程序并行扫描对象图
3.STW终止(短暂暂停):处理剩余标记
4.并发清除:回收白色对象(未标记对象) -
触发条件:堆内存增长2倍 / 定时触发 / 手动调用
runtime.GC()
4.3 总结
- 分析工具:pprof(采样分析)、trace(可视化全链路)
- 内存管理:分级缓存分配 + 低延迟并发GC
- 优化方向:减少分配次数、避免STW过长、复用高频对象
5.Mysql的索引为什么是b+树?
- 索引是加快查询的一种数据结构,其原理是插入时对数据排序,缺点是会影响插入的性能;
- MySQL 当前支持 B+树索引、全文索引、R 树索引;
- B+ 树索引的高度通常为 3~4 层,高度为 4 的 B+ 树能存放 50 亿左右的数据;
- 由于 B+ 树的高度不高,查询效率极高,50 亿的数据也只需要插叙 4 次 I/O;
- MySQL 单表的索引没有个数限制,业务查询有具体需要,创建即可,不要迷信个数限制;
- 可以通过表 sys.schema_unused_indexes 和索引不可见特性,删除无用的索引;
相关链接:B+树详解
6.mysql的大表分页查询如何做优化?
大表分页优化核心:避免扫描大量无效数据
方案:
- 覆盖索引+延迟关联:用索引先查主键,再回表,减少扫描行数。
- 书签式分页:记录上一页最后主键/时间,下一页直接定位(如
WHERE id > last_id LIMIT 10)。 - 限制最大分页深度:禁止
LIMIT offset中offset过大(如前端限制页数≤1000)。 - 索引优化:给
ORDER BY和过滤字段加复合索引。
7.redis的底层数据结构?
Redis是一个基于内存的数据存储系统,它支持多种数据结构和数据类型: 下面是Redis支持的主要数据结构及其对应的数据类型:
- 字符串(String):字符串是Redis中最简单的数据结构,可以存储文本、数字等任意类型的数据。在Redis中,字符串类型被用于缓存、计数器等场景。
- 列表(List):列表是一个有序的字符串集合,可以包含重复的元素。在Redis中,列表适用于存储按顺序排列的数据,比如消息队列、任务列表等。
- 哈希表(Hash):哈希表是一个键值对集合,每个键值对都存储在一个哈希表中。在Redis中,哈希表适用于存储对象的属性和值之间的映射关系,比如存储用户信息、配置信息等。
- 集合(Set):集合是一个无序的字符串集合,不允许重复元素。在Redis中,集合适用于存储唯一的、不重复的数据,比如用户标签、文章标签等。
- 有序集合(Sorted Set):有序集合是一个有序的字符串集合,每个字符串都关联一个分数(score)。在Redis中,有序集合适用于存储按分数排序的数据,比如排行榜、计分系统等。
8.redis的主库崩溃了会怎么样?
- 读写分离失效:从库只读,主库无法处理写请求。
- 数据写入暂停:客户端写操作会报错(如READONLY)。
- 故障转移触发(若配置哨兵 / 集群):哨兵自动选举从库为主库,恢复写能力。
- 数据丢失风险:未同步到从库的写数据可能丢失(取决于repl-backlog和持久化配置)。
- 手动恢复:需排查主库故障原因,修复后可重新加入集群(或作为新从库)。
9.redis切片集群中,数据量多了,加实例还是加内存,为什么?
加实例。
- 水平扩展存储能力:切片集群通过哈希槽分配数据,加实例可增加哈希槽数量,分散数据存储压力。
- 避免单节点瓶颈:加内存仅提升单节点容量,无法解决数据分布不均和集群整体性能问题。
- 符合分布式设计:通过增加节点数扩展集群规模,提升读写吞吐量和可用性。
10.tcp的拥塞控制?
网络拥塞:网络中的数据太多,导致某个路由器处理不过来或者处理的太慢。 拥塞控制:在网络中发生拥塞时,减少向网络中发送数据的速度,防止造成恶性循环;同时在网络空闲时,提高发送数据的速度,最大限度地利用网络资源。
1.慢启动(Slow Start): 初始阶段,TCP发送⽅会以较⼩的发送窗⼝开始传输数据。随着每次成功收到确认的数据,发送⽅逐渐增加发送窗⼝的⼤⼩,实现指数级的增⻓,这称为慢启动。这有助于在⽹络刚开始传输时谨慎地逐步增加速率,以避免引发拥塞。
2.拥塞避免(Congestion Avoidance): ⼀旦达到⼀定的阈值(通常是慢启动阈值),TCP发送⽅就会进⼊拥塞避免阶段。在拥塞避免阶段,发送⽅以线性增加的⽅式增加发送窗⼝的⼤⼩,⽽不再是指数级的增⻓。这有助于控制发送速率,以避免引起⽹络拥塞。
3.快速重传(Fast Retransmit): 如果发送⽅连续收到相同的确认,它会认为发⽣了数据包的丢失,并会快速重传未确认的数据包,⽽不必等待超时。这有助于更快地恢复由于拥塞引起的数据包丢失。
4.快速恢复(Fast Recovery): 在发⽣快速重传后,TCP进⼊快速恢复阶段。在这个阶段,发送⽅不会回到慢启动阶段,⽽是将慢启动阈值设置为当前窗⼝的⼀半,并将拥塞窗⼝⼤⼩设置为慢启动阈值加上已确认但未被快速重传的数据块的数量。这有助于更快地从拥塞中恢复。
相关链接:TCP 拥塞控制
11.kafka是基于磁盘存储,为什么高性能?
其 Reactor I/O 网络模型、磁盘顺序写入、内存映射文件、零拷贝、数据压缩和批量处理等技术,为 Kafka 提供了强大的数据处理能力和高效的消息队列服务:
- Reactor I/O 网络模型:通过I/O 多路复用机制,Kafka 能够同时处理大量的网络连接请求,而不需要为每个连接创建一个线程,从而节省了系统资源。
- 顺序写入:Kafka 使用顺序写入的方式将消息追加到日志文件的末尾,避免了文件位置的频繁变动,从而减少了锁的使用。
- MMAP 内存映射文件:Kafka 使用内存映射文件(Memory Mapped File)来访问日志数据和索引文件。这种方式使得文件数据可以直接映射到进程的虚拟地址空间中,从而减少了系统调用的开销,提高了数据访问的效率。
- 零拷贝:Kafka 使用零拷贝(Zero Copy)技术,将数据从磁盘直接传输到网络,绕过了用户态的复制过程,大大提高了数据传输的效率。
- 数据压缩和批量处理:数据压缩在 Kafka 中有助于减少磁盘空间的使用和网络带宽的消耗,从而提升整体性能。;Kafka 支持批量处理消息,在一个批次中同时处理多个消息,减少了网络和 I/O 的开销。
相关链接:Kafka 性能优化
13.讲一下GMP机制
GMP 指的是 Go 的运⾏时系统(Runtime)中的三个关键组件:Goroutine、M(Machine)、P(Processor)。
Goroutine: Goroutine是Go语言中轻量级的线程,它由Go运行时管理。Goroutine是并发执行的基本单位,相比于传统的线程,他们更轻量,并由云心那个是的系统调动。 M(Machine):表示调度器的线程,它负责将Goroutine映射到真正的操作系统线程上。当一个Goroutine需要执行时,他会被分配给一个M,并在该M的线程上运行。 P(Processor):表示处理器,他是用于执行Goroutine的上下文,它保存了Goroutines的执行状态、调度队列等信息。
工作原理如下:
- 当一个Goroutine被创建时,他会被放入一个P的本地队列。
- 当P的本地队列满了,或者某个Goroutine长时间没有被调度执行时,P会尝试从全局队列中获取Goroutine。
- 如果全局队列也为空,P会从其他P的本地队列中偷取一些Goroutines,以保证尽可能多的利用所有的处理器。
- M的数量决定了同时并发执行的Goroutine数目。如果某个M阻塞(比如在系统调用中),他的工作会被其他M接管。
参考链接:GMP 机制
14.Go面向对象是怎么实现的?
Go没有类的概念,而是通过结构体(struct)和接口(interface)来实现面向对象的特性。
-
结构体是⼀种⽤户定义的数据类型,可以包含字段(成员变量)和⽅法(成员函数)。
1
2
3
4
5
6
7
8
 type Person struct {
 Name string
 Age int
 }
 // ⽅法
 func (p *Person) SayHello() {
 fmt.Println("Hello, my name is", p.Name)
 }
-
Go语⾔通过接⼝来定义对象的⾏为,⽽不是通过明确的继承关系。⼀个类型只要实现了接⼝定义的⽅法,就被视为实现了该接⼝。
1
2
3
4
5
6
7
8
9
10
 type Speaker interface {
 Speak()
 }
 type Person struct {
 Name string
 }
 // Person 实现了 Speaker 接⼝
 func (p *Person) Speak() {
 fmt.Println("Hello, my name is", p.Name)
 }
-
Go语⾔通过结构体的组合特性来实现对象的组合。⼀个结构体可以包含其他结构体作为其字段,从⽽实现对象的复⽤。
-
尽管Go语⾔没有像传统⾯向对象语⾔那样的私有成员访问修饰符,但通过⾸字⺟⼤⼩写来控制成员的可⻅性,实现了封装的效果。⾸字⺟⼤写的成员是公有的,可以被外部包访问;⾸字⺟⼤写的成员是私有的,只能在定义的包内访问。
15.Go语言中,切片里有几种属性体现其数据结构?
- 指针:指向切片底层数组的第一个元素
- 长度:表示切片中元素的数量
- 容量:表示切片底层数组的大小,即从切片的第一个元素到其底层数组末尾的元素数量
16.Go语言中, Channel被关闭了,再读写会发生什么?
- 读操作:当从已关闭的
channel读取数据时,会立即返回该channel元素类型的零值,且ok标志位为false。例如,若channel是int类型,读操作会返回0和false。 - 写操作:向已关闭的
channel写入数据会导致panic异常,程序会崩溃。这是因为关闭channel后再写入数据会破坏channel的状态,引发不可预期的结果。
17.Go语言中,会有一个什么语法来防止我程序挂掉?
在 Go 语言中,可以使用recover函数来防止程序因panic而挂掉。recover只能在defer函数中使用,用于捕获panic并恢复程序的正常执行。
1
2
3
4
5
6
7
8
9
10
11
12
13
func main() {
    defer func() {
        if r := recover(); r != nil {
            // 这里可以记录错误信息等
            fmt.Println("程序出现panic,已恢复:", r)
        }
    }()

    // 假设这里有一个可能会导致panic的操作,比如向已关闭的channel写数据
    ch := make(chan int, 1)
    close(ch)
    ch <- 1 // 这会导致panic
}
上述代码中,defer语句中的recover函数会捕获到panic,并打印出相关信息,使程序不会直接挂掉。这样就可以在程序出现异常时进行一些善后处理,而不是让程序崩溃。